
知识库
搜索测试与检索调优
掌握知识库搜索测试工具、混合检索模式切换、相似度得分分析与未命中排障排查方案。
在将知识库挂载到具体应用前,通过独立的“搜索测试”工具可以隔离应用提示词与模型生成干扰,直接验证底层向量与全文索引的召回精度。
步骤一:打开搜索测试工具
- 进入目标知识库,点击顶部导航栏中的“搜索测试”标签页。
- 页面包含测试输入区、右上角“搜索配置”按钮、“测试”按钮、测试历史以及测试结果列表。点击右上角“搜索配置”打开“知识库搜索配置”弹窗,在 搜索方式 标签页选择检索模式与重排,在 搜索过滤 标签页设置“引用上限”与“最低相关度”。
- 输入代表真实业务场景的测试提问,例如:
出差回来后多久提交报销?。
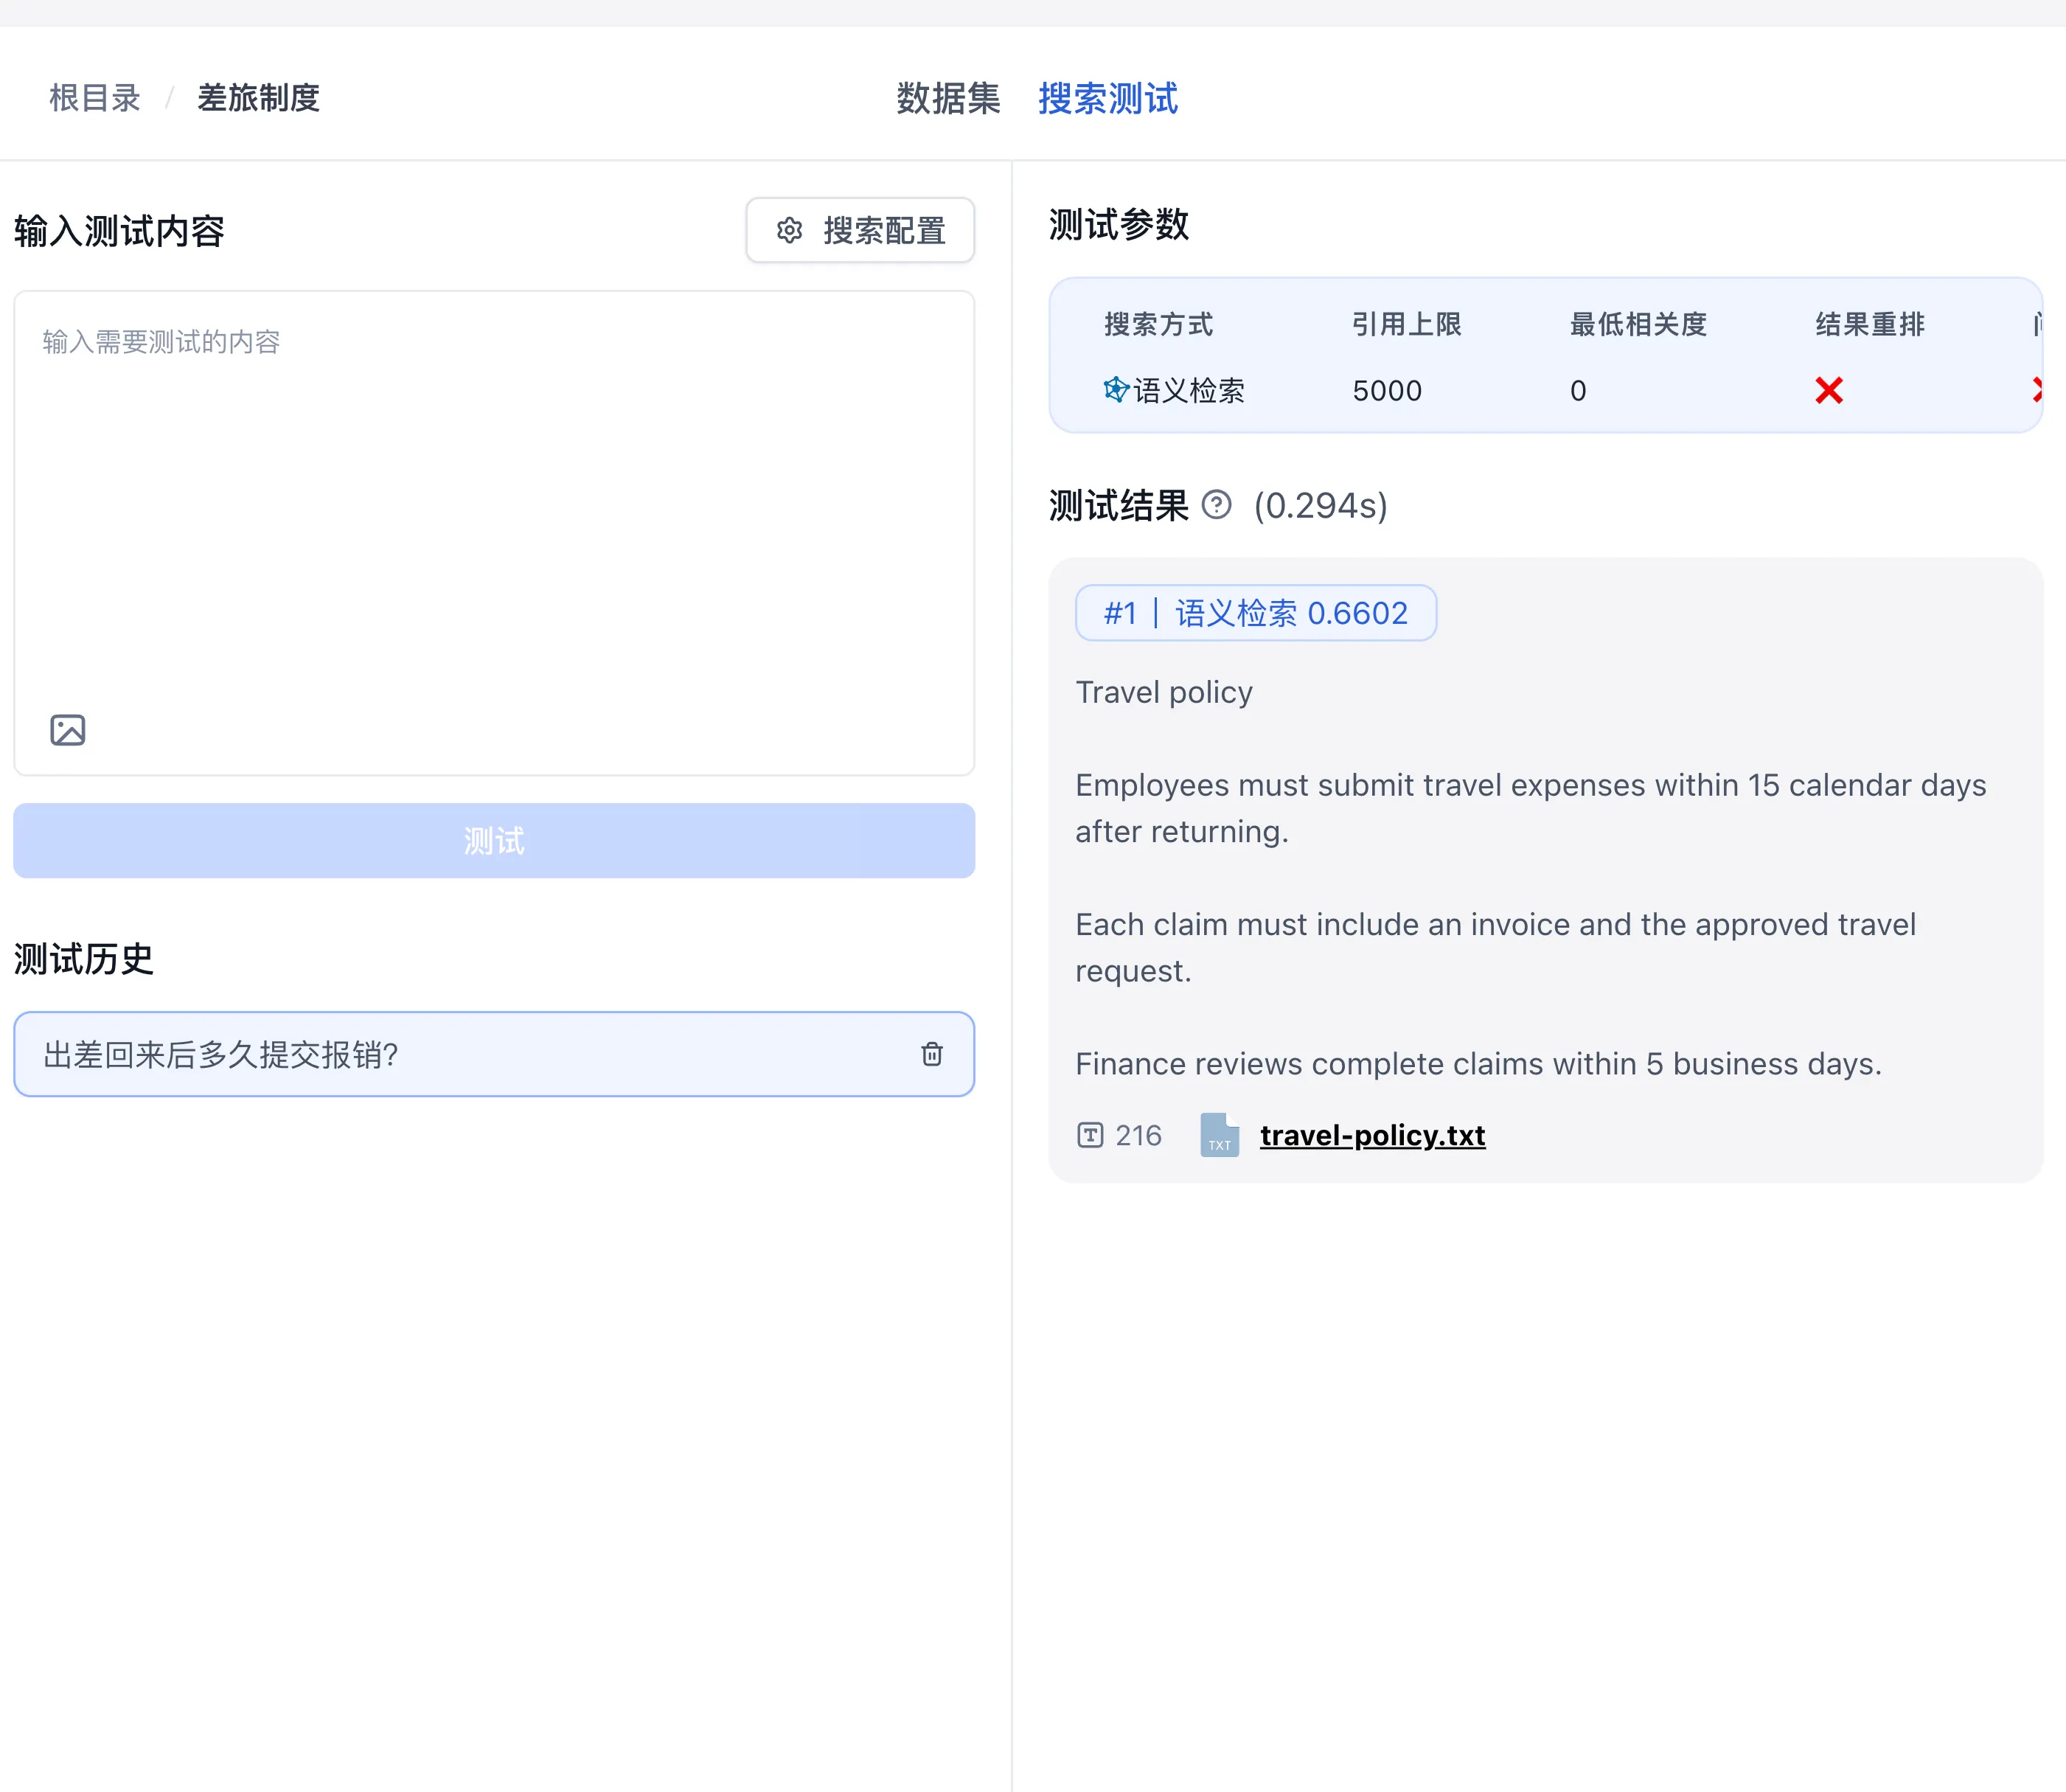
步骤二:切换搜索方式并对比召回
在“知识库搜索配置”弹窗的“搜索方式”中切换不同选项,观察返回候选块的得分变化:
- 语义检索(Semantic Search):
输入包含同义改写的提问(例如
差旅结束后多久能报账?)。系统根据高维语义距离匹配,准确召回包含“15 个自然日”的数据块。 - 全文检索(Keyword Search):
输入包含生僻专有名词或规章代号的提问(例如
依据财审发 [2026] 3 号文第 15 条)。检查全文检索是否返回包含该文号的原文。 - 混合检索(Hybrid Search,推荐): 结合向量召回与全文召回的各自优势。系统合并多路候选;配置并启用重排模型后,可进一步重排。
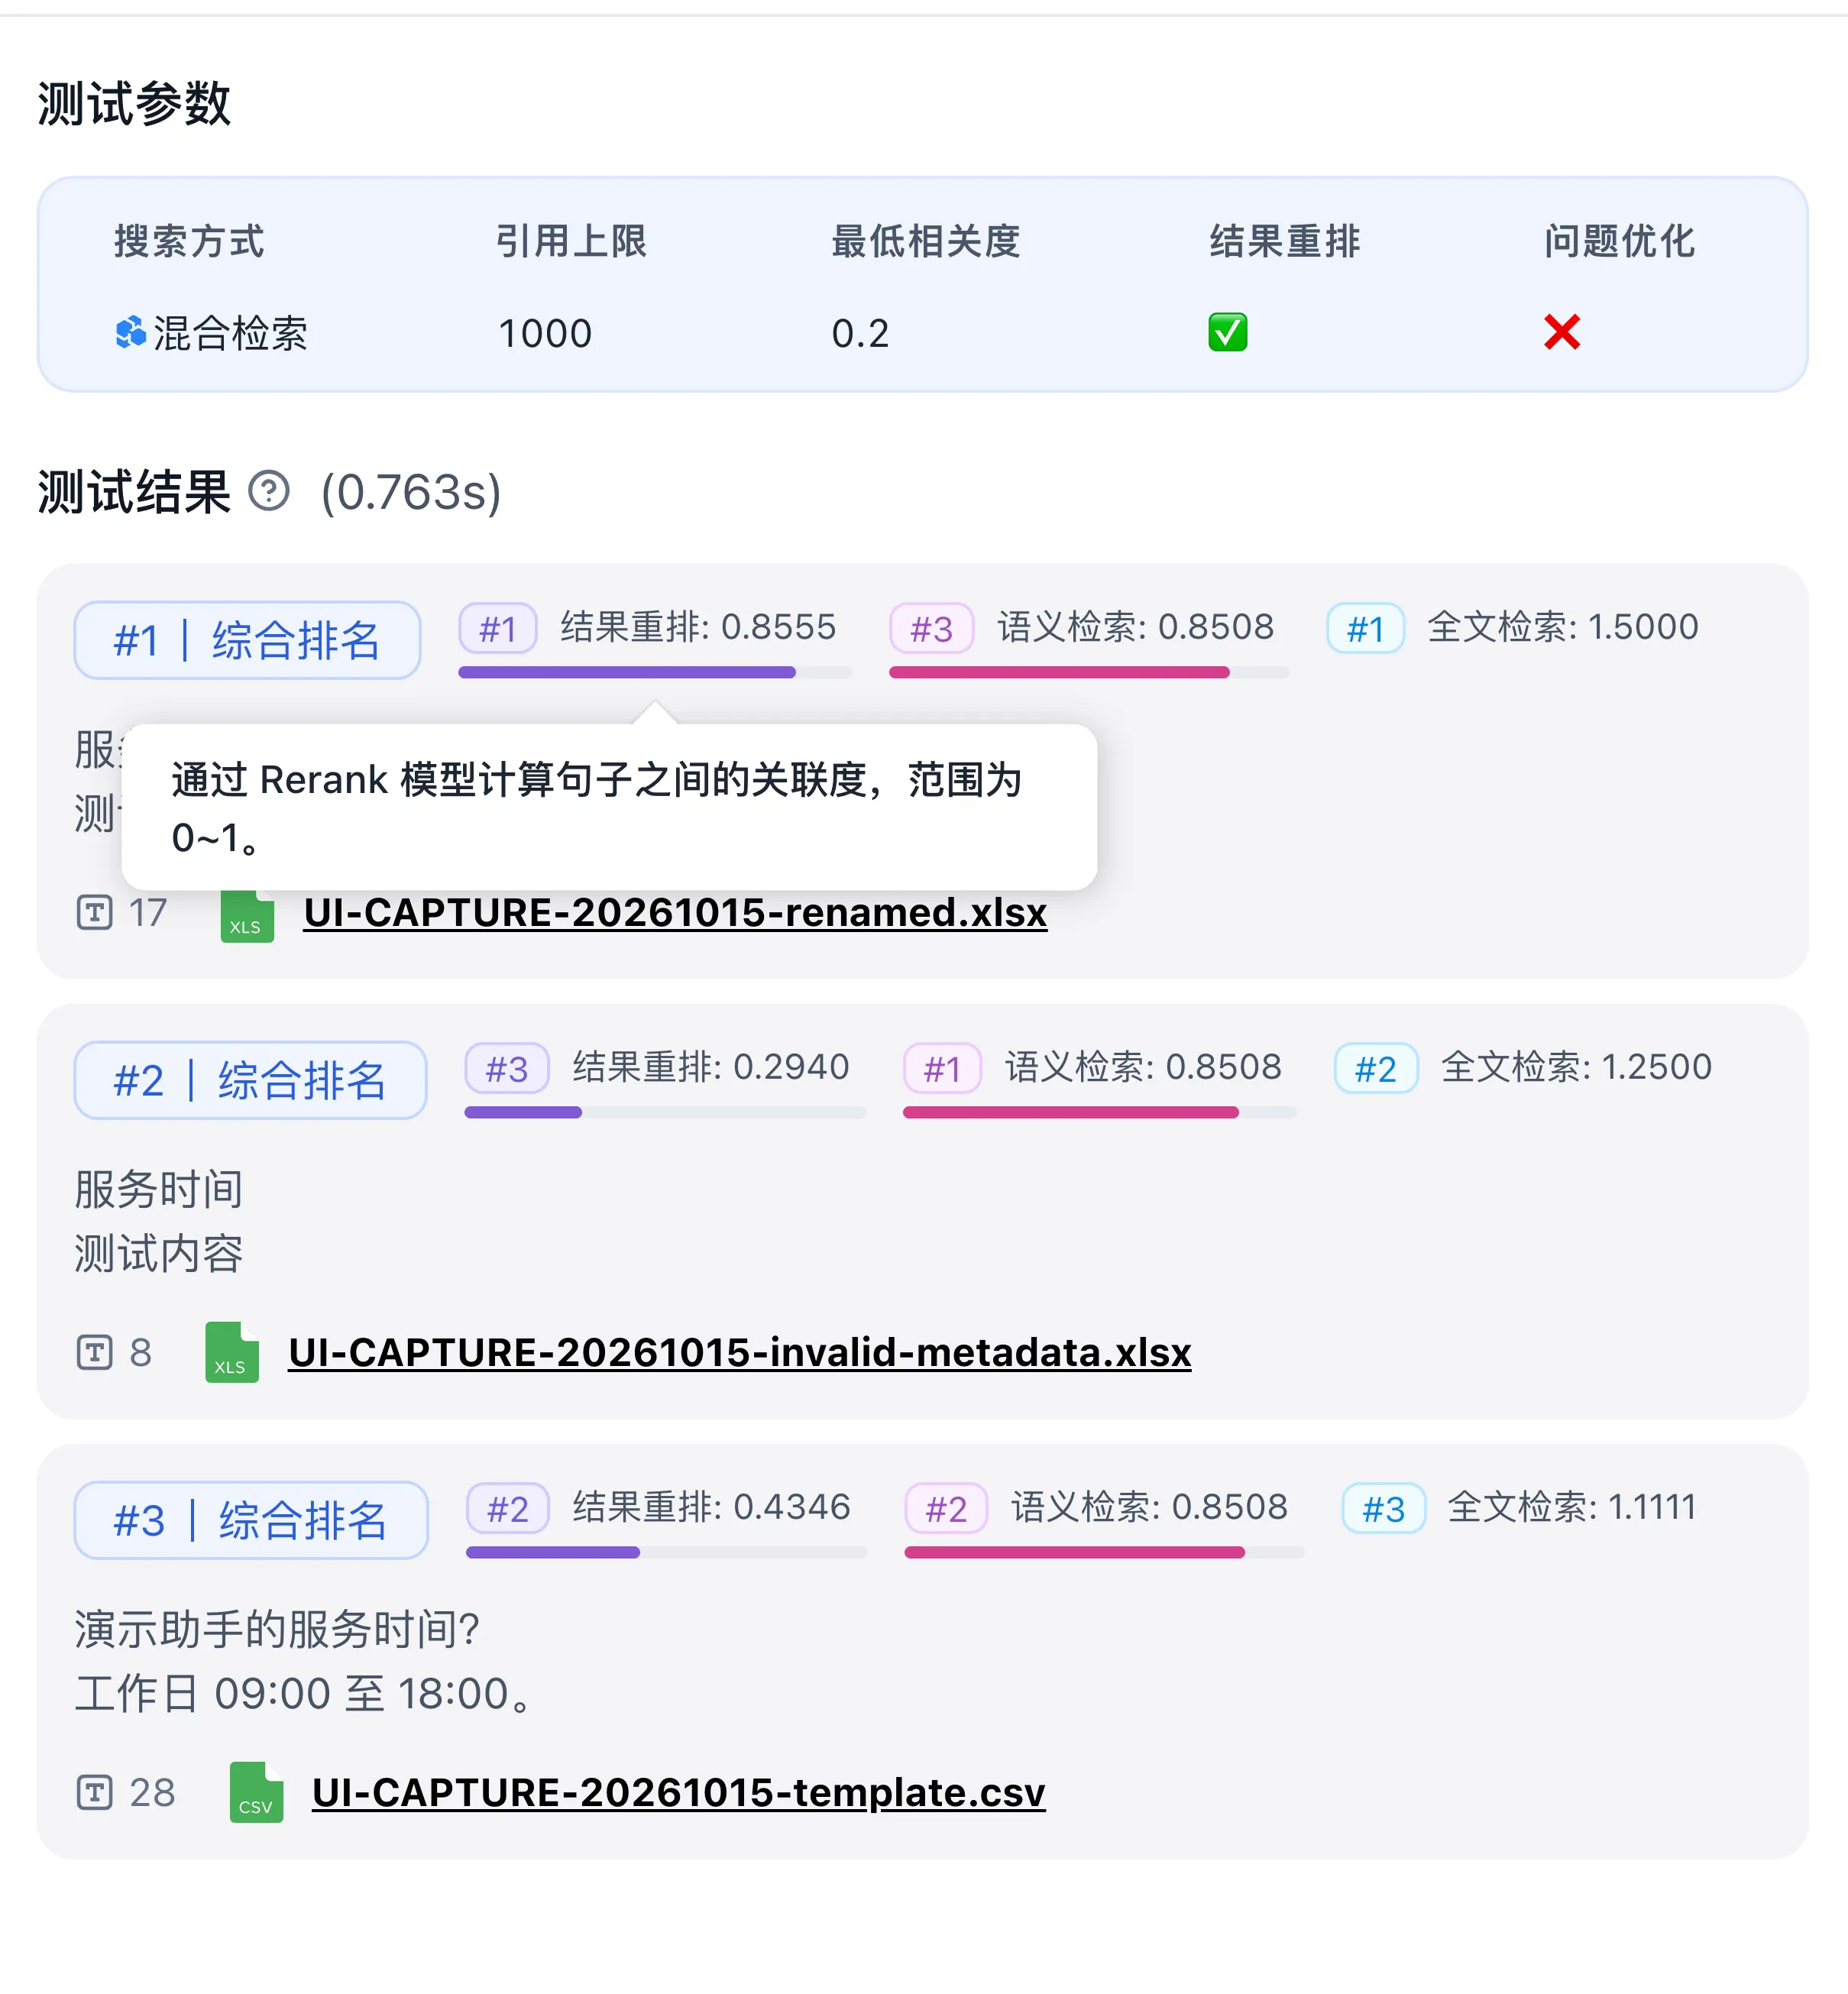
步骤三:分析得分并校准最低相关度阈值
在相同模型与检索配置下比较候选得分。准备包含有答案问题、同义改写、精确编号和知识库范围外问题的标注测试集,为有答案问题记录预期来源分块。
调优实操基准
- 从较低阈值开始,确认预期分块进入候选列表。
- 每次调整一个参数,比较正确命中、遗漏依据和无关结果,再选择阈值。
- 更换向量模型、重排模型或分块策略后重新校准。界面提供实际重排和过滤状态时,一并核对。
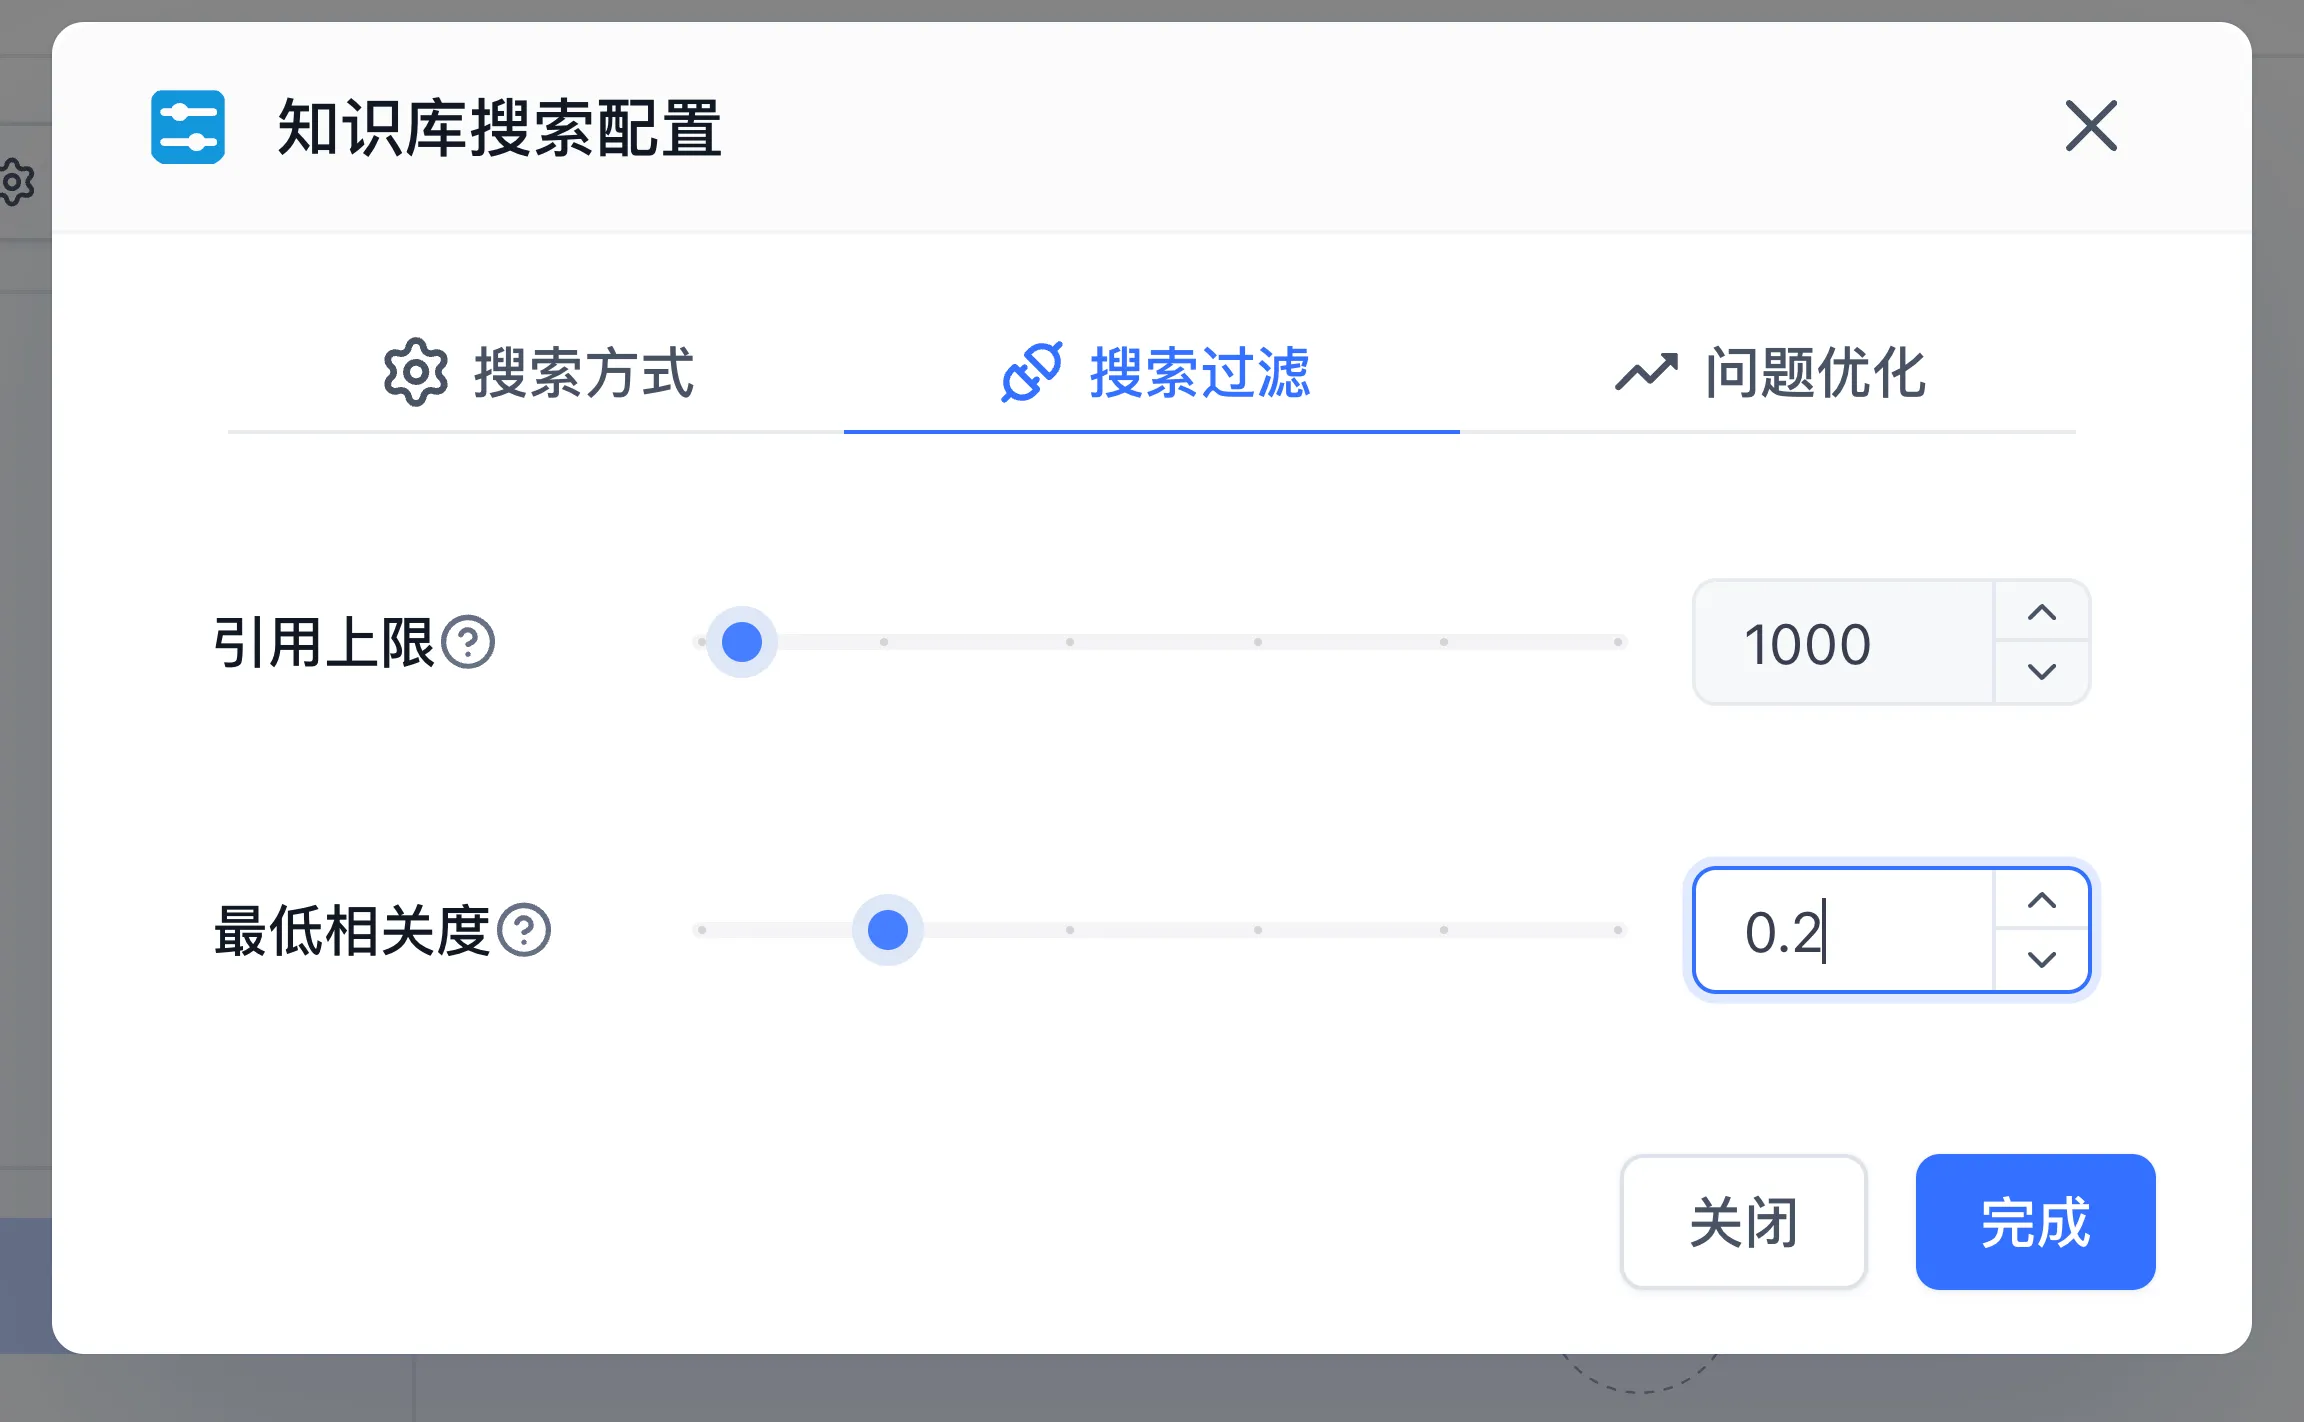
步骤四:检索未命中排查流程
当输入预期问题却未能召回目标分块时,按以下四步顺序排查:
| 排查步骤 | 检查要点 | 修复措施 |
|---|---|---|
| 1. 核查分块完整性 | 打开数据集分块列表,搜索该条规章原文 | 确认目标知识点已被成功收录,且未被切片跨段落异常截断 |
| 2. 检查索引构建状态 | 查看集合列表中该文件的索引状态 | 确认集合状态处于“已就绪”,若处于“训练异常”状态则在“异常列表”弹窗中重试训练 |
| 3. 评估分词覆盖率 | 检查全文检索模式下专有名词是否被意外切碎 | 在提问中补充完整标准术语,或切换为混合检索结合语义召回(Milvus 环境下可通过环境变量 MILVUS_LANGUAGE_IDENTIFIER 调整分词语言识别策略) |
| 4. 补充辅助同义索引 | 针对该数据块添加扩展问题描述 | 点击目标数据块打开编辑弹窗,在下方的 数据索引(N) 区域点击 新增,手动添加 3 ~ 5 个用户常见提问 |
下一步
在 GitHub 上编辑
文件更新时间